Editoria digitale multilingue: traduzione e metadati gestiti con l'IA
Tradurre, controllare incrociato e mettere in vendita un catalogo editoriale in quattro lingue, con l'intelligenza artificiale che lavora lungo tutta la filiera — dalla traduzione alla scheda del libro sugli store, fino alla difesa dai testi piratati. È il lavoro fatto per Digital Index, la casa editrice digitale che dirigo fra Modena e la Francia: saggi, guide, romanzi, fumetti e manuali in italiano, francese, inglese e giapponese, venduti su Amazon, Apple Books, Google Play e Kobo.
Il catalogo
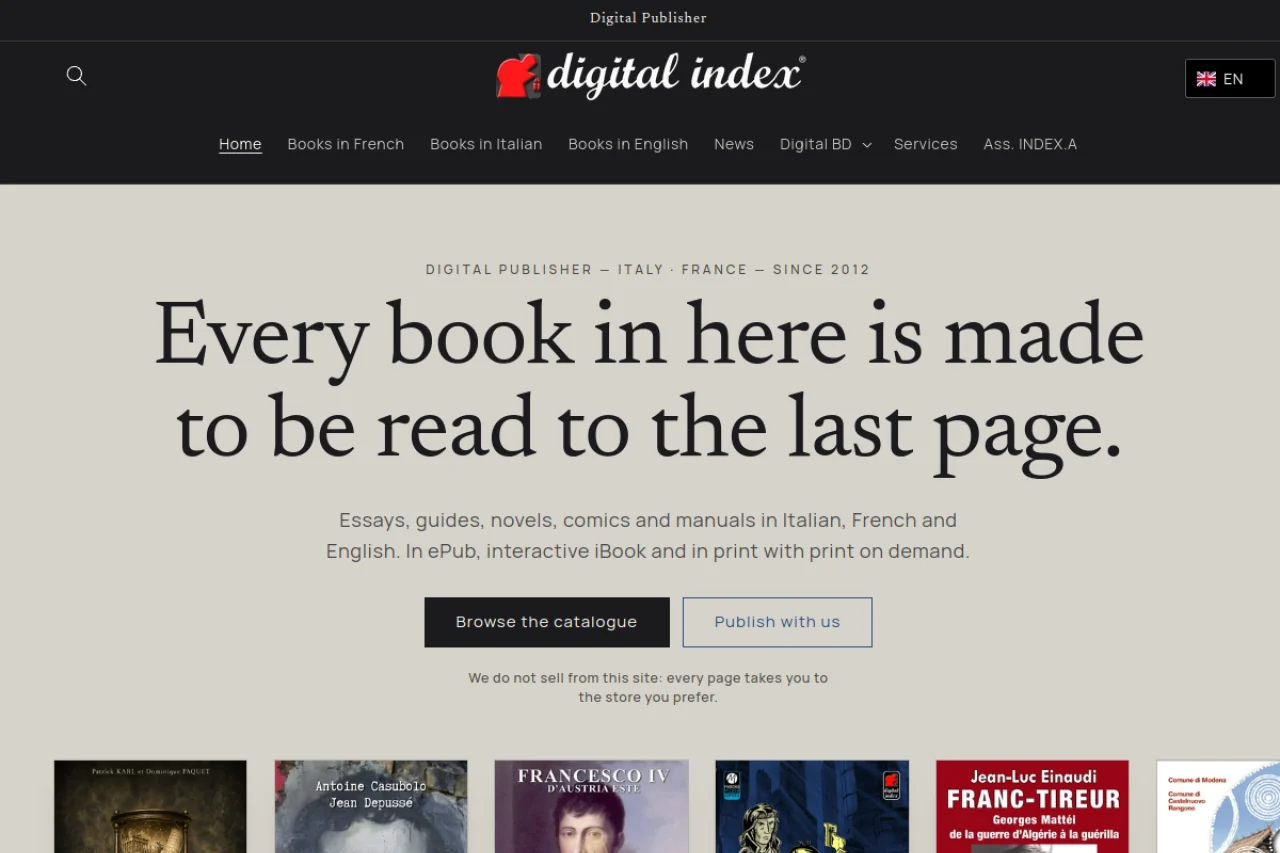
Alla ricognizione di fine agosto 2026 il catalogo era ordinato in collane, con i titoli già pubblicati e altri in lavorazione. Il sito è una vetrina in tre lingue: non vende direttamente, porta il lettore allo store che preferisce. Ogni scheda libro ha l'elenco dei rivenditori con il formato disponibile — ebook o cartaceo — così chi arriva da una ricerca trova il punto d'acquisto giusto al primo colpo.
Come l'IA entra nella filiera
- Traduzioni: le prime versioni sono prodotte con più modelli linguistici, messi a confronto per scegliere la resa migliore.
- Adattamenti: i testi vengono adattati al pubblico di ogni lingua — tono, riferimenti culturali, titoli, esempi — non tradotti parola per parola.
- Verifica incrociata: ogni traduzione è controllata da un'IA diversa da quella che l'ha prodotta, che segnala omissioni, errori di senso e incoerenze. La revisione finale resta umana, e serve: su un articolo storico l'ultima correzione ha rimesso al posto giusto un dettaglio che cambiava il senso di tutto il passaggio.
- Glossari e coerenza: nomi, termini tecnici e stile restano identici in tutti i volumi di una collana e in tutte le lingue.
- Editing e produzione: correzione di bozze, uniformità redazionale, conversione nei formati richiesti dagli store.
Metadati: la parte che nessuno vede e che decide le vendite
Un ebook si vende attraverso la sua scheda, non attraverso il libro. Per ogni titolo sono stati messi in ordine i dati che gli store e i motori di ricerca leggono: codice ISBN dell'edizione digitale e di quella cartacea come campo strutturato, codice a barre, elenco dei rivenditori, categoria, versione linguistica, tipo di copertina.
Titolo e descrizione per i motori di ricerca sono stati riscritti per tutti i titoli e in tutte le lingue del sito, insieme alle descrizioni delle collane e alle pagine biografiche degli autori. In ogni scheda libro è stato inserito un blocco di dati strutturati che dichiara esplicitamente ai motori "questa pagina è un libro, ecco autore, editore e codice". Tredici indirizzi del vecchio sito sono stati reindirizzati ai nuovi, per non perdere il posizionamento già guadagnato.
Farsi trovare dagli assistenti IA
Il punto di partenza è stato misurato, non immaginato: un anno intero di dati di Search Console mostrava un sito già indicizzato per intero, con moltissime visualizzazioni e pochi clic, e una posizione media ancora lontana dalla prima pagina. Il dato più interessante era un altro: nel rapporto sulle ricerche generate dall'IA, le impressioni arrivavano quasi tutte dagli articoli del blog, quasi nessuna dalle schede dei libri.
Da lì è nato un piano editoriale con un'uscita a settimana, scritta in un formato preciso: la risposta alla domanda nelle prime righe, e sotto l'approfondimento. È la forma che gli assistenti IA riescono a citare. Ogni articolo esce nelle tre lingue del sito. Il primo pubblicato con questo criterio era in inglese e puntava a una domanda concreta di chi cerca libri su un tema specifico, non a una parola chiave generica.
Una regola editoriale accompagna tutto il lavoro: la casa editrice non si posiziona sulla città in cui ha sede. È un editore europeo, e gli argomenti da manuale per aspiranti autori — come si pubblica un ebook, cos'è una casa editrice digitale — sono stati esclusi apposta: portano visite sbagliate.
Difendere i libri dalla pirateria
Un saggio del catalogo francese è finito in circolazione su una decina di piattaforme diverse, in PDF e in ePub, e in un caso veniva perfino rivenduto a pagamento da un sito terzo. È stata costruita una routine di monitoraggio che gira quasi ogni giorno: cerca le copie non autorizzate sui motori e sulle piattaforme di condivisione documenti, verifica se gli indirizzi rispondono ancora e tiene il registro di ogni segnalazione e del suo esito.
Le segnalazioni non vanno solo alla piattaforma. Seguono la catena: piattaforma, fornitore di hosting, registrar del dominio, motori di ricerca per la rimozione dai risultati e, quando serve, l'autorità nazionale competente del paese in cui l'host ha sede. Gli esiti verificati sono concreti: su una piattaforma di documenti gli indirizzi sono stati rimossi alla fonte, su un'altra l'account che aveva caricato il file è stato disattivato il giorno stesso, il sito che vendeva il PDF è sparito in ventiquattr'ore dopo il reclamo al suo fornitore, un file-esca ospitato da un servizio americano è stato tolto. Restano aperti i casi su piattaforme fuori dall'Unione europea, dove la normativa non arriva.
Un dettaglio operativo ha richiesto una soluzione su misura: le diffide devono partire dall'indirizzo ufficiale dell'editore, e lo strumento di posta collegato spediva solo dalla casella personale. È stato scritto un invio automatico che usa direttamente il server di posta del dominio.
Risultato: un catalogo multilingue gestito da una struttura piccola, con le schede di vendita curate in ogni lingua, una presenza costruita per farsi citare dagli assistenti IA oltre che dai motori, e una difesa dalla pirateria che funziona per passi documentati invece che per segnalazioni isolate.