SEO e GEO: farsi trovare da Google e dalle IA
Un sito oggi deve farsi trovare due volte: da Google, come è sempre stato, e dagli assistenti IA — ChatGPT, Gemini, Perplexity, Claude — che sempre più spesso rispondono al posto del motore di ricerca. Sono due lavori diversi, e vanno fatti tutti e due.
Che cosa cambia quando a leggere è un assistente
Un motore di ricerca mostra un elenco di link: basta comparire. Un assistente, invece, dà una risposta sola e cita una fonte sola. Per essere quella fonte, un sito deve dire in modo esplicito chi è, che cosa fa e dove opera, in una forma che una macchina legga senza ambiguità.
Su uno dei siti che ho rifatto il problema era proprio questo: il sito dichiarava due organizzazioni diverse nelle sue schede nascoste, e nessun assistente riusciva a legare il nome del marchio al mestiere. L'ho unificato su un solo nome, ripetuto identico ovunque — intestazione, piè di pagina, schede per le macchine, profili esterni, firma delle email. È così che un assistente capisce che si sta parlando sempre della stessa azienda.
I dati strutturati: dire al software che cosa sei
I dati strutturati sono un blocco di testo invisibile al lettore che descrive la pagina in un linguaggio standard, capito da Google e dalle IA. Non è decorazione: è la carta d'identità della pagina.
- Per uno studio professionale: scheda della persona, dell'organizzazione e del servizio, con indirizzo, coordinate geografiche, zona servita e fascia di prezzo.
- Per un catalogo di corsi: ogni corso come voce a sé, in un elenco leggibile dalla macchina.
- Per un ristorante: scheda del locale con posizione, menù, logo e profili social collegati.
- Per una casa editrice: la scheda «libro» con i link agli store, applicata a tutto il catalogo in tre lingue.
- Per un archivio di immagini: ogni foto con autore, titolare dei diritti, didascalia e licenza d'uso dichiarata — così chi la riusa sa a quali condizioni.
- Per le pagine con le domande frequenti: la marcatura che permette all'assistente di pescare la singola risposta.
Vale anche il contrario: non si marca quello che non è vero. Su un sito di eventi ho lasciato fuori i campi su biglietti e artisti, perché non c'erano dati certi: una dichiarazione falsa danneggia più di una mancante.
Il file per gli assistenti, e la porta aperta ai loro crawler
Accanto ai file classici ne esiste uno nuovo, llms.txt: una mappa scritta per gli assistenti IA, che spiega com'è organizzato il sito e dove trovare le pagine giuste. Su un sito trilingue è un documento di circa 6.000 caratteri con la tabella dei punti d'ingresso per lingua di 12 sezioni; su un altro l'ho riscritto perché quello generato dalla piattaforma parlava solo di carrello e pagamenti: per un ristorante, fuorviante.
Poi c'è il problema opposto, che quasi nessuno controlla: il sito può essere chiuso in faccia alle IA senza che il proprietario lo sappia. Su un server con 26 domini ho misurato che GPTBot, ClaudeBot, PerplexityBot e Applebot ricevevano un rifiuto secco, mentre Google e i browser normali entravano regolarmente. Non dipendeva dai siti né dal loro software: era una regola del fornitore di hosting. Ho documentato la misura dominio per dominio e l'ho fatta rimuovere: dal 14 agosto 2026 tutti e quattro i crawler entrano e leggono la pagina vera.
Mappa del sito, lingue, indirizzi vecchi
La mappa del sito (la sitemap, l'elenco degli indirizzi da far leggere ai motori) va generata dal sito stesso, non scritta a mano. Su un sito in tre lingue il generatore produce l'elenco completo — home, categorie e articoli, in ciascuna lingua — con i rimandi incrociati fra le versioni linguistiche, e una mappa separata delle immagini che oggi copre migliaia di foto. Prima di sovrascrivere i file veri, ogni singolo indirizzo viene provato uno per uno.
Le lingue vanno dichiarate con i collegamenti incrociati corretti, altrimenti Google tratta le traduzioni come contenuti duplicati: su quel sito ogni articolo ha il suo gruppo di traduzione completo, senza un solo buco. E vanno recuperati gli indirizzi vecchi: 180 pagine storiche rispondevano «non trovato» per una regola sbagliata nella configurazione del server, e sono state rimesse in piedi con un risolutore automatico.
Un controllo automatico che avvisa quando si rompe qualcosa
Il lavoro fatto una volta si disfa da solo: un aggiornamento, un plugin, una modifica del fornitore. Per questo ogni sito importante ha un controllo automatico che gira da sé ogni tre giorni e verifica, senza intervento umano:
- tutti gli indirizzi della mappa del sito, uno per uno, con il loro stato reale;
- la validità dei dati strutturati su un campione di 25 pagine;
- la presenza della licenza dichiarata sulle immagini;
- i file per i motori e per gli assistenti;
- lo stato dei quattro crawler IA, che deve restare «aperto».
Se il conteggio dei problemi è a zero non succede nulla. Se non lo è, arriva un avviso su Telegram con il dettaglio. È un controllo senza IA dentro: uno script che misura e basta, e quindi costa niente farlo girare. Un altro sito ha un guardiano simile su un altro fronte: ogni giorno rinomina le immagini caricate senza il prefisso descrittivo, perché chi carica se ne dimentica sempre.
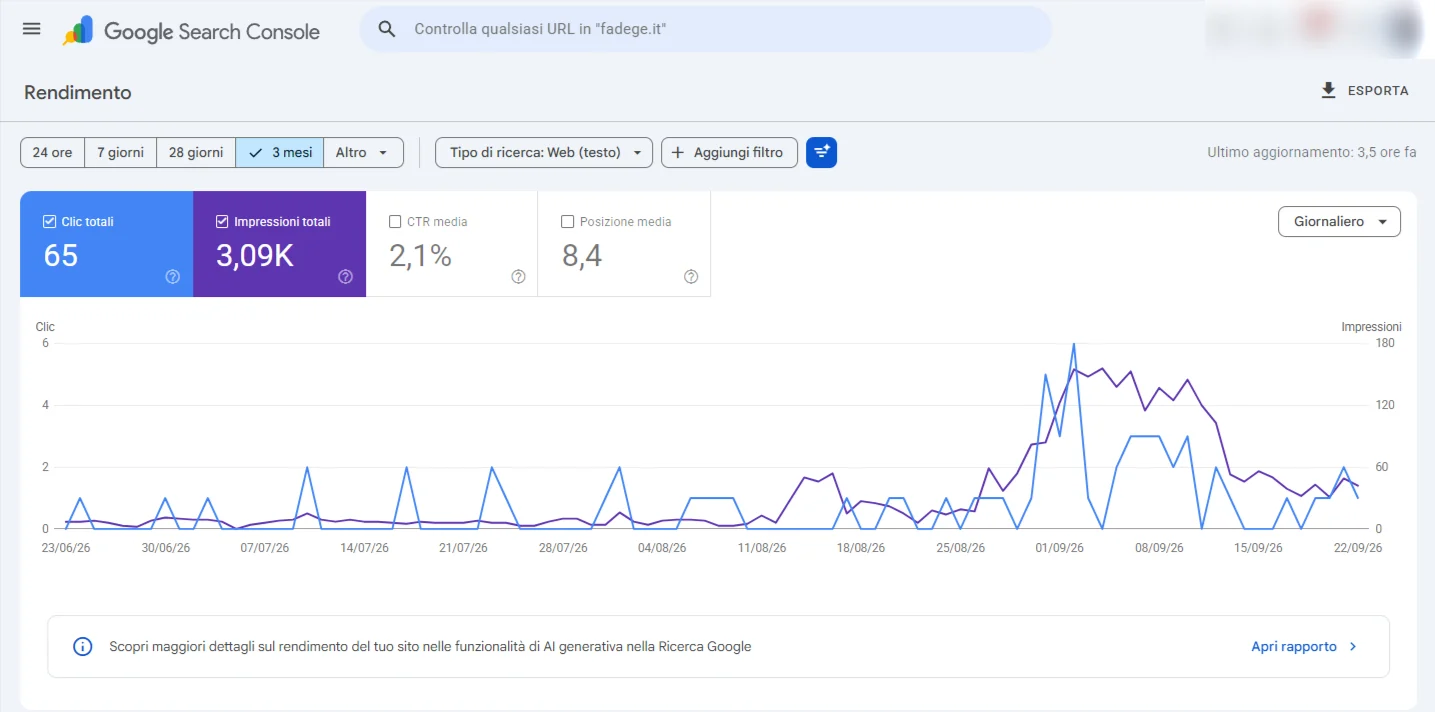
Risultato: su un sito seguito così, le pagine indicizzate da Google sono più che raddoppiate in tre settimane, e i quattro principali crawler delle IA, che prima venivano respinti, ora leggono l'intero sito.