SEO et GEO : se faire trouver par Google et par les IA
Aujourd'hui, un site doit se faire trouver deux fois : par Google, comme cela a toujours été, et par les assistants IA (ChatGPT, Gemini, Perplexity, Claude) qui répondent de plus en plus souvent à la place du moteur de recherche. Ce sont deux travaux différents, et il faut faire les deux.
Ce qui change quand c'est un assistant qui lit
Un moteur de recherche affiche une liste de liens : il suffit d'y figurer. Un assistant, lui, donne une seule réponse et cite une seule source. Pour être cette source, un site doit dire de façon explicite qui il est, ce qu'il fait et où il opère, sous une forme qu'une machine lit sans ambiguïté.
Sur l'un des sites que j'ai refaits, le problème était exactement celui-là : le site déclarait deux organisations différentes dans ses fiches cachées, et aucun assistant n'arrivait à relier le nom de la marque au métier. Je l'ai unifié sur un seul nom, répété à l'identique partout : en-tête, pied de page, fiches pour les machines, profils externes, signature des e-mails. C'est ainsi qu'un assistant comprend qu'on parle toujours de la même entreprise.
Les données structurées : dire au logiciel ce que vous êtes
Les données structurées sont un bloc de texte invisible pour le lecteur qui décrit la page dans un langage standard, compris par Google et par les IA. Ce n'est pas de la décoration : c'est la carte d'identité de la page.
- Pour un cabinet professionnel : fiche de la personne, de l'organisation et du service, avec adresse, coordonnées géographiques, zone desservie et fourchette de prix.
- Pour un catalogue de formations : chaque formation comme une entrée à part, dans une liste lisible par la machine.
- Pour un restaurant : fiche de l'établissement avec position, menu, logo et profils sociaux reliés.
- Pour une maison d'édition : la fiche « livre » avec les liens vers les boutiques, appliquée à tout le catalogue en trois langues.
- Pour une photothèque : chaque photo avec auteur, titulaire des droits, légende et licence d'utilisation déclarée, afin que celui qui la réutilise sache à quelles conditions.
- Pour les pages de questions fréquentes : le balisage qui permet à l'assistant de piocher la réponse précise.
L'inverse vaut aussi : on ne balise pas ce qui n'est pas vrai. Sur un site d'événements, j'ai laissé de côté les champs sur les billets et les artistes, faute de données certaines : une déclaration fausse nuit plus qu'une déclaration manquante.
Le fichier pour les assistants, et la porte ouverte à leurs robots d'exploration
À côté des fichiers classiques, il en existe un nouveau, llms.txt : une carte écrite pour les assistants IA, qui explique comment le site est organisé et où trouver les bonnes pages. Sur un site trilingue, c'est un document d'environ 6 000 caractères avec le tableau des points d'entrée par langue pour 12 rubriques ; sur un autre, je l'ai réécrit parce que celui généré par la plateforme ne parlait que de panier et de paiements : pour un restaurant, c'était trompeur.
Il y a ensuite le problème inverse, que presque personne ne contrôle : le site peut être fermé aux IA sans que son propriétaire le sache. Sur un serveur hébergeant 26 domaines, j'ai mesuré que GPTBot, ClaudeBot, PerplexityBot et Applebot recevaient un refus net, alors que Google et les navigateurs ordinaires entraient normalement. Cela ne dépendait ni des sites ni de leur logiciel : c'était une règle du fournisseur d'hébergement. J'ai documenté la mesure domaine par domaine et je l'ai fait retirer : depuis le 14 août 2026, les quatre robots entrent et lisent la vraie page.
Plan du site, langues, anciennes adresses
Le plan du site (la sitemap, la liste des adresses à faire lire aux moteurs) doit être généré par le site lui-même, pas écrit à la main. Sur un site en trois langues, le générateur produit la liste complète (accueil, catégories et articles, dans chaque langue) avec les renvois croisés entre les versions linguistiques, ainsi qu'un plan distinct des images qui couvre aujourd'hui des milliers de photos. Avant d'écraser les vrais fichiers, chaque adresse est testée une par une.
Les langues doivent être déclarées avec les liens croisés corrects, sinon Google traite les traductions comme des contenus dupliqués : sur ce site, chaque article a son groupe de traduction complet, sans le moindre trou. Et il faut récupérer les anciennes adresses : 180 pages historiques répondaient « introuvable » à cause d'une mauvaise règle dans la configuration du serveur, et elles ont été remises en service grâce à un résolveur automatique.
Un contrôle automatique qui prévient quand quelque chose se casse
Le travail fait une fois se défait tout seul : une mise à jour, un plugin, une modification du fournisseur. C'est pourquoi chaque site important dispose d'un contrôle automatique qui tourne seul tous les trois jours et vérifie, sans intervention humaine :
- toutes les adresses du plan du site, une par une, avec leur état réel ;
- la validité des données structurées sur un échantillon de 25 pages ;
- la présence de la licence déclarée sur les images ;
- les fichiers destinés aux moteurs et aux assistants ;
- l'état des quatre robots IA, qui doit rester « ouvert ».
Si le nombre de problèmes est à zéro, il ne se passe rien. Sinon, une alerte arrive sur Telegram avec le détail. C'est un contrôle sans IA à l'intérieur : un script qui mesure, rien de plus, et donc le faire tourner ne coûte rien. Un autre site a un gardien similaire sur un autre front : chaque jour, il renomme les images téléversées sans le préfixe descriptif, parce que celui qui les téléverse l'oublie toujours.
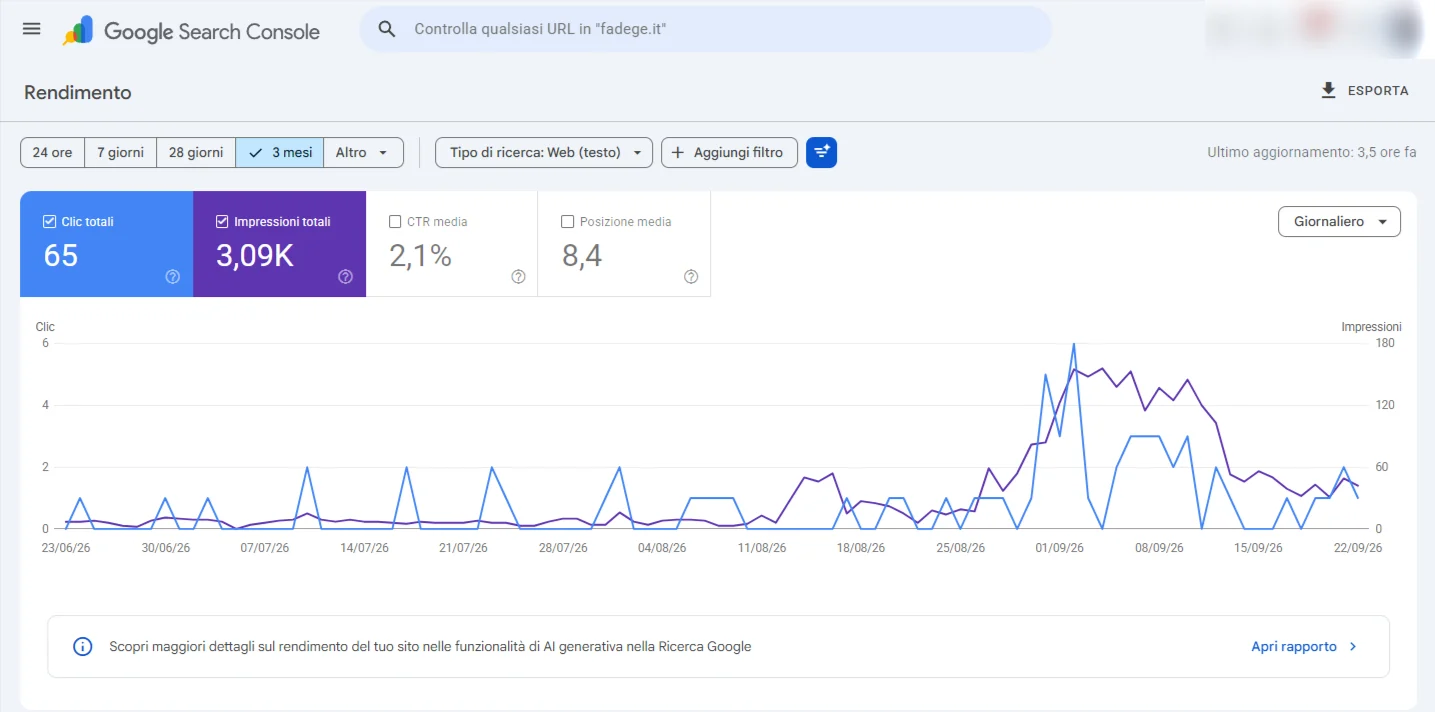
Résultat : sur un site suivi de cette manière, les pages indexées par Google ont plus que doublé en trois semaines, et les quatre principaux robots des IA, qui étaient auparavant repoussés, lisent désormais l'ensemble du site.